






Dynamic Resource Allocation(DRA) 정리 - device plugin을 대체하는 쿠버네티스 하드웨어 할당 표준
쿠버네티스 1.34 기준으로 정리합니다. GPU 같은 특수 하드웨어를 쿠버네티스가 다루는 방식이 device plugin에서 Dynamic Resource Allocation(DRA)으로 바뀌고 있습니다. 왜 바뀌는지, 실제로 무엇이 달라지는지, 어떻게 쓰는지 순서로 정리합니다.
무엇이 문제였나 - device plugin의 한계
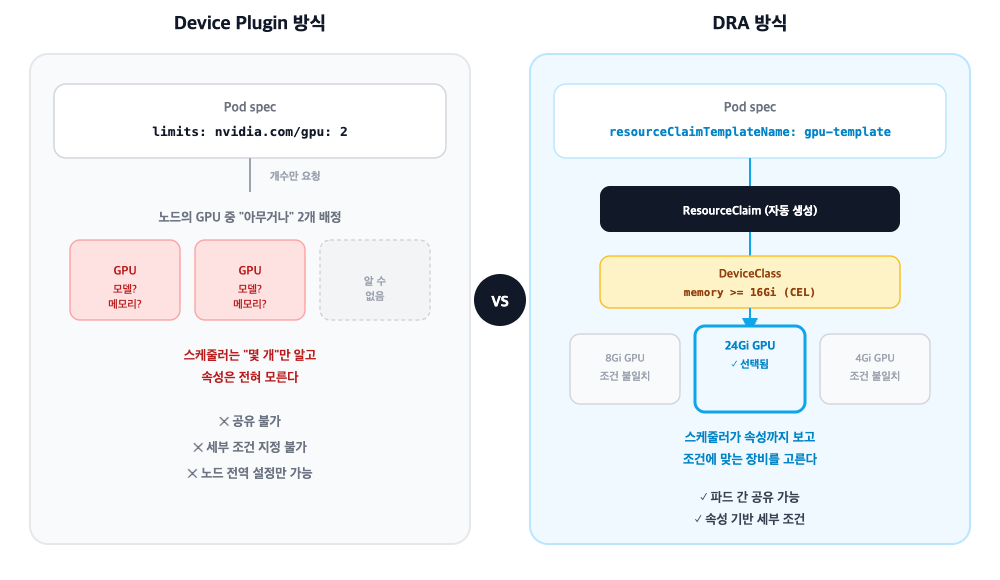
MIG(Multi-Instance GPU) 정리 글에서 다룬 것처럼, 지금까지 쿠버네티스에서 GPU를 쓰려면 파드 스펙에 resources.limits.nvidia.com/gpu: 1처럼 개수만 적었습니다. 이 방식을 device plugin이라고 부릅니다.
문제는 "개수"만으로는 표현할 수 없는 요구사항이 많다는 점입니다. 어떤 모델의 GPU인지, 메모리가 얼마나 필요한지, 다른 파드와 같은 GPU를 나눠 써도 되는지 - 이런 세부 조건은 쿠버네티스 스케줄러가 전혀 모르고, 각 벤더가 만든 플러그인이 알아서 처리했습니다. 클러스터 관리자 입장에서는 GPU 배치가 "블랙박스"였던 셈입니다.
무엇이 바뀌나 - 핵심 개념 3가지
DRA는 하드웨어 요청을 스케줄러가 이해할 수 있는 3개의 리소스로 표준화합니다.
| 리소스 | 역할 |
|---|---|
| DeviceClass | 클러스터 관리자가 만드는 "장비 카테고리". CEL(Common Expression Language, 조건식을 쓰는 표현 언어) 표현식으로 장비 속성을 필터링 |
| ResourceClaim | 실제로 장비 하나(또는 여러 개)를 요청하는 개별 신청서. 파드가 이걸 참조 |
| ResourceClaimTemplate | Deployment처럼 파드가 여러 개 뜰 때, 파드마다 ResourceClaim을 자동으로 찍어내는 틀 |
비유하면 DeviceClass는 "회의실 대여 규정"이고, ResourceClaim은 "이 회의를 위한 예약 신청서"입니다. 규정은 관리자가 미리 정해두고, 신청은 필요할 때마다 합니다.
device plugin과 무엇이 다른가
| 구분 | Device Plugin | DRA |
|---|---|---|
| 요청 방식 | limits.nvidia.com/gpu: 2 (개수만) |
ResourceClaim 참조 (속성 기반) |
| 필터링 | 노드별 정적 설정 | CEL로 메모리·컴퓨트 능력 등 동적 필터링 |
| 장비 공유 | 불가능 | 여러 파드가 같은 클레임을 참조해 공유 가능 |
| 커스텀 설정 | 노드 전역 설정만 | 클레임 단위로 세부 파라미터 오버라이드 가능 |
어떻게 쓰나 - 예시 매니페스트
메모리 16Gi 이상인 GPU만 걸러내는 DeviceClass를 만들고, Deployment가 파드마다 자동으로 클레임을 생성하게 하는 예시입니다.
apiVersion: resource.k8s.io/v1
kind: DeviceClass
metadata:
  name: gpu-high-performance
spec:
  selectors:
  - cel:
      expression: "device.attributes['memory'] >= 16Gi"
---
apiVersion: apps/v1
kind: Deployment
metadata:
  name: ml-training
spec:
  replicas: 3
  template:
    spec:
      containers:
      - name: training
        image: nvidia/cuda:12.4.0-base-ubuntu22.04
        resources:
          requests:
            cpu: "4"
            memory: "8Gi"
      resourceClaims:
      - name: gpu
        source:
          resourceClaimTemplateName: gpu-template
---
apiVersion: resource.k8s.io/v1
kind: ResourceClaimTemplate
metadata:
  name: gpu-template
spec:
  spec:
    deviceClassName: gpu-high-performance
여기서 봐야 할 부분: DeviceClass의 selectors.cel.expression이 "메모리 16Gi 이상"이라는 조건을 정의하고, Deployment는 GPU 개수를 직접 적지 않고 resourceClaimTemplateName으로 그 조건을 참조합니다. replicas: 3이면 ml-training-gpu-xxxx 형태로 파드마다 독립된 ResourceClaim이 자동 생성됩니다 - device plugin이었다면 세 파드 모두 그냥 "GPU 1개"만 요청할 뿐, 어떤 조건의 GPU인지는 지정할 수 없었습니다.
왜 지금 중요한가 - NVIDIA의 드라이버 기증
2026년 3월 KubeCon EU(암스테르담)에서 NVIDIA는 CNCF 플래티넘 멤버로 승격하면서, 자사 GPU DRA 드라이버를 CNCF에 기증했습니다. 이 드라이버는 별도 샌드박스 프로젝트가 아니라 쿠버네티스 프로젝트 자체 아래로 편입돼, 사실상 커뮤니티가 소유하는 레퍼런스 구현체가 됐습니다.
이 드라이버가 지원하는 기능에는 MIG와 Multi-Process Service(MPS)를 통한 GPU 공유, Grace Blackwell 시스템의 멀티노드 NVLink 지원, 런타임 중 하드웨어 재구성이 포함됩니다. 지금까지 별도 오퍼레이터·플러그인으로 따로 다뤄지던 MIG 같은 기능이, DRA라는 하나의 표준 API 위에서 일관되게 다뤄지는 방향으로 가고 있다는 뜻입니다.
주의할 점 - 선점(preemption) 미지원
아직 초기 단계라 운영 전 알아둬야 할 제약이 있습니다. DRA 리소스를 점유 중인 파드는 더 높은 우선순위의 파드가 와도 선점(preemption, 낮은 우선순위 파드를 강제로 내리고 높은 우선순위 파드를 먼저 배치하는 것)되지 않습니다. 높은 우선순위 파드는 장비가 자연스럽게 해제될 때까지 그냥 Pending 상태로 대기합니다. GPU가 귀한 클러스터를 운영한다면, 이 부분 때문에 급한 작업이 기다리는 일이 없도록 스케줄링·쿼터 설계를 미리 해둬야 합니다.
요약
DRA는 device plugin의 "개수만 요청" 한계를 넘어, 하드웨어 속성 기반 요청·공유·세부 설정을 표준 API로 가능하게 합니다. Kubernetes 1.34에서 GA, 1.35부터는 기본 활성화(잠금)됐고, NVIDIA가 GPU 드라이버를 CNCF에 기증하면서 GPU 워크로드 생태계의 기본값이 되는 중입니다. 다만 선점 미지원 등 아직 다듬어지는 부분이 있으니, 운영 클러스터 도입 전에는 제약사항을 먼저 확인하는 것이 안전합니다.
참고사항
'DevOps > Kubernetes' 카테고리의 다른 글
| Kustomize 정리 - base와 overlay로 환경별 매니페스트 관리하기 (0) | 2026.09.30 |
|---|---|
| kubectl 생산성 도구 모음 - krew로 설치하는 실전 플러그인 5가지 (0) | 2026.09.30 |
| Gateway API Inference Extension 정리 - LLM 추론 트래픽을 위한 쿠버네티스 네이티브 라우팅 (0) | 2026.09.28 |
| Cilium Service Mesh 정리 - eBPF 기반 사이드카 없는 쿠버네티스 네트워킹 (0) | 2026.09.22 |
| Kueue 정리 - Kubernetes 배치 작업 큐 관리와 GPU 쿼터 스케줄링 (0) | 2026.09.21 |